并查集
概念
不相交集合:若有n个元素,其中的每个元素如果只属于某个集合,则可以把他们划为不想交集合
问题描述:将编号分别为1-n的n个对象划分为不相交集合,在每个集合中,选择其中某个元素代表所在集合
解决的问题:
定义一个数组set,set[i]代表i所在的集合
我们用每个集合编号最小的元素标记所在集合
实现1
如set: 1 2 1 4 2 6 1 6 2 2
他的不相交集合为{1,3,7}, {4}, {2,5,9,10}, {6,8}
效率
查:只需要返回下标对应元素,因为此时对应的就是集合中的最小元素,
1
2
3
| find1(x){
return set[x];
}
|
并:合并两个集合后,要找出一个更小的作为代表元素,合并时要遍历set中所有元素,把还是原来元素的改成新的更小元素,
1
2
3
4
5
6
7
| merge1(a,b){
i = min(a,b);
j = max(a,b);
for (int k=1;k<=n;k++){
if (set[k]==j) set[k]==i;
}
}
|
实现2
每个集合用一颗有根树表示
定义一个数组set
- 若set[i]=i, 则i为该树的根节点,i代表本集合
- 若set[i]=j, 若ji,
则j是i的父节点
效率
查:如果集合对应的不是自己,则自己上面有父节点,将父节点存下来继续查找直到查到根节点,最坏,一般
1
2
3
4
5
6
7
| find2(x){
r = x;
while(set[r]!=r){
r = set[r];
}
return r;
}
|
并:只需要将根节点改为另一个集合的根节点即可,
1
2
3
| merge2(a,b){
set[a]=b;
}
|
改进
如何避免最坏情况?
方法:将深度小的树合并到深度大的树,合并后深度不会变化
效果:合并后,包含k个节点的树最大高度不超过
代码: 在合并时记录每棵树的高度,谁的高度大谁是新的根节点
1
2
3
4
5
6
7
8
| merge3(a,b){
if (height(a)==height(b)){
height(a)=height(a)+1;
set[b]=a;
}
else if (height(a)<height(b)) set[a]=b;
else set[b]=a;
}
|
此时查找操作的时间复杂度变成了
路径压缩
问题:若一棵树的高度很大,查找路径很长,查找量很大的时候,很容易tle
思想:查找时如果路径较长,则修改信息,让下次查找的时候速度更快
方案:
- 找到根节点
- 修改查找路径上的所有节点,将它们都指向根节点
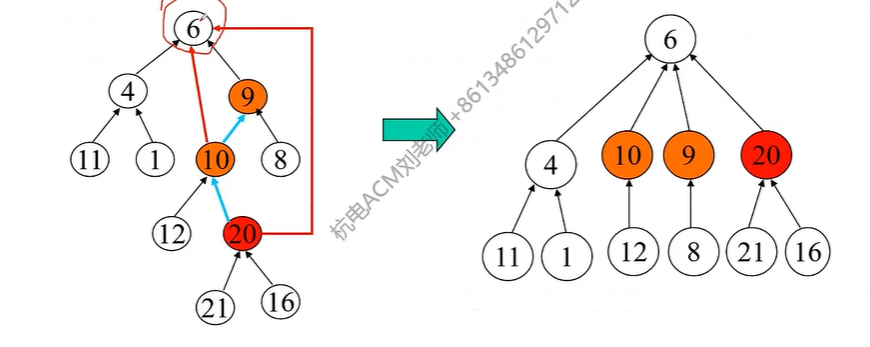
代码
1
2
3
4
| find3(x){
if (set[x]!=x) set[x]=find3(set[x]);
return set[x];
}
|
模板
题目描述
如题,现在有一个并查集,你需要完成合并和查询操作。
输入格式
第一行包含两个整数 ,表示共有
个元素和 个操作。
接下来 行,每行包含三个整数
。
当 时,将 与 所在的集合合并。
当 时,输出 与 是否在同一集合内,是的输出
Y ;否则输出 N 。
输出格式
对于每一个
的操作,都有一行输出,每行包含一个大写字母,为 Y 或者
N 。
样例 #1
样例输入 #1
1
2
3
4
5
6
7
8
| 4 7
2 1 2
1 1 2
2 1 2
1 3 4
2 1 4
1 2 3
2 1 4
|
样例输出 #1
提示
对于 的数据,,。
对于 的数据,,。
对于 的数据,,,,。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
| #include <bits/stdc++.h>
using namespace std;
const int N = 1e6+10;
template<typename T>
class DSU{
public:
DSU(T n){
this->n = n;
disj.resize(n+1);
cnt.resize(n+1);
iota(disj.begin()+1, disj.end(), (T)1);
fill(cnt.begin()+1, cnt.end(), (T)1);
}
T find(T x){
if(disj[x]!=x) disj[x]=find(disj[x]);
return disj[x];
}
void merge(T a,T b){
T ra = find(a);
T rb = find(b);
if(cnt[rb]<cnt[ra]) swap(ra,rb);
if(ra!=rb){
disj[ra] = rb;
cnt[rb]+=cnt[ra];
}
}
T fcnt(){
vector<bool> vis(n+1, false);
T ans = 0;
for (int i = 0;i<=n;i++){
if (!vis[find(i)]){
vis[find(i)]=1;
ans++;
}
}
return ans;
}
private:
vector<T> disj;
vector<T> cnt;
vector<bool> vis;
T n;
};
int n, m;
int main(){
cin >> n >>m;
DSU<int> dsu(n);
while(m--){
int z, x, y;
cin>>z>>x>>y;
if (z==1){
dsu.merge(x,y);
}
else {
if(dsu.find(x)==dsu.find(y)) cout << "Y"<<endl;
else cout << "N"<<endl;
}
}
return 0;
}
|
种类并查集
一般的并查集维护的是具有连通性的一组关系,而对于一个具有多种关系(相斥或相互独立),我们需要使用种类并查集,亦称拓展域并查集
种类并查集是一种数据结构,用于解决具有多个相互关系集合的问题。它是传统并查集的扩展,能够处理集合间的不同关系,如相互排斥或相互独立的关系。
例:
该题使用贪心,可以把矛盾关系从大到小排序,将矛盾关系大的关到不同监狱中
但给出的信息是存在仇恨不能出现在同一监狱的两个人,故不能用传统并查集的思路处理
这里我们开两倍大小的并查集(拓展域),用前一半维护朋友关系,后一半维护敌人关系
假如共有4人,1是2的敌人,那我们将1和2+4合并,1+4和2合并,即1和6是敌人,5和2是敌人,又5和6是敌人关系,故1和5是朋友,5又和2是敌人,故1和2是敌人,2和1同理
故我们需要每次merge(i,j+n)与merge(i+n,j)来建立关系
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
| #include <bits/stdc++.h>
#define endl '\n'
using namespace std;
typedef long long ll;
typedef pair<int,int> PII;
const int N = 2e4 + 10;
const int mod = 1e9 + 7;
struct node{
int x, y, z;
}pri[100050];
int disj[2*N];
int find(int x){
if(disj[x]!=x)disj[x]=find(disj[x]);
return disj[x];
}
void merge(int a, int b){
if (find(a)>find(b))disj[find(a)] = find(b);
else disj[find(b)]=find(a);
}
void solve() {
int n,m;
cin >> n >> m;
for (int i =1;i<=m;i++){
cin >> pri[i].x >> pri[i].y >> pri[i].z;
}
sort(pri+1,pri+m+1, [&](const node a, const node b){return a.z>b.z;});
for (int i = 1;i<=n*2;i++){
disj[i]=i;
}
for (int i =1;i<=m;i++){
if (find(pri[i].x)==find(pri[i].y)){
cout <<pri[i].z;
return ;
}
merge(pri[i].x+n,pri[i].y);
merge(pri[i].x,pri[i].y+n);
}
cout << 0;
}
int main()
{
ios::sync_with_stdio(0); cin.tie(0); cout.tie(0);
int tomorin=1;
while (tomorin--) solve();
return 0;
}
|
