基于视频8小时转职Golang工程师
by 刘丹冰做的笔记
也有看了一点官方文档的部分补充
Go开发环境
/golang文件夹下
src:源码仓库
bin:编译环境,将该文件夹配置到环境变量中
Linux
在家目录下的~/.bashrc中配置环境变量:
1 2 3 4 export GOROOT=/usr/local/goexport GOPATH=$HOME /go export PATH=$PATH :$GOROOT /bin:$GOPATH /bin
运行source ~/.bashrc更新环境
Windows
在环境变量中Path中添加go根目录bin文件夹作为GOROOT
在环境变量中添加GOPATH作为工作目录,之后可以使用modules独自管理
基本语法
程序书写
1
2
3
4
5
6
package main import "fmt" func main () fmt.Println("hello world!" ) }
1
2
3
4
5
import "包名" import ( "包1" "包2" )
函数的左花括号一定要和当前函数名在同一行,习惯需要改
编译运行
go run 源代码:编译+运行go build 源代码:编译,编译后生成的可执行文件可以直接运行go fmt 源代码:格式化
变量
使用
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
package mainimport "fmt" func main () var a int var b int = 10 var c float64 var d string = "abc" fmt.Println("a=" , a) fmt.Println("b=" , b) fmt.Println("c=" , c) fmt.Println("d=" , d) var e = 10 var f = "acd" fmt.Printf("type of e = %T\n" , e) fmt.Printf("type of f = %T\n" , f) g := 100 fmt.Printf("type of g = %T\n" , g) fmt.Println("g=" , g) var a1, a2 int = 10 , 20 fmt.Println("a1=" ,a1,"a2=" ,a2) var a3, a4 = "aa" , 10 fmt.Println("a3=" ,a3,"a4=" ,a4) var ( a5 int = 100 a6 bool = true ) fmt.Println("a5=" ,a5,"a6=" ,a6) }
常用的是方法四,直接自动匹配,但是方法四不支持全局变量
变量定义了必须用,不然会报错
用_定义匿名变量,可以不使用
实现
GoLang中的变量是由两部分构成的一个pair,分别是变量的类型type和值value
类型又分为静态类型(static type)和具体类型(concrete type)
静态类型为基本类型,如int, string等
具体类型指interface具体指向的数据类型,或者是系统看得见的类型
常量
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
package mainimport "fmt" func main () const length int = 10 fmt.Println("length=" , length) const ( A = 0 B = 1 C = 2 ) const ( X = 10 *iota Y Z ) fmt.Println("X = " , X) fmt.Println("Y = " , Y) fmt.Println("Z = " , Z) }
使用const定义常量,定义后不能修改
const括号可以定义枚举,枚举内使用iota实现自增
注意:iota自增论行算,若某一行同时定义两个变量,他们对应的iota值是一样的
iota可以用在表达式里,表达式计算出的结果就是对应的枚举值
控制语句
选择控制
if-else if-else:
1
2
3
4
5
6
7
8
9
if expression1 {}else if expression2 { }else if expression3 { }else { }
不要单行开
switch-case:
1
2
3
4
5
6
7
8
switch expr { case case1: statement1 case case2: statement2 default : default statement }
1
2
3
4
5
6
7
8
9
10
11
func main () switch num := f(); { case num >= 0 && num <= 1 : num++ case num > 1 : num-- fallthrough case num < 0 : num += num } }
循环控制
Golang中只有for循环
1
2
3
for init statement; expression; post statement { execute statement }
当只保留循环条件expression时就和while一样了
1
2
3
for expression { execute statement }
下面是一个死循环
1
2
3
for { execute statement }
可以用for range迭代器来遍历一些可以迭代的数据
1
2
3
for index, value := range iterable { }
你甚至可以迭代一个整型值,字面值,常量,变量
函数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
package mainimport "fmt" func fool (a string , b int ) int { fmt.Println("a=" , a) fmt.Println("b=" , b) return 100 } func fool2 (a string , b int ) int , int ) { fmt.Println("a=" , a) fmt.Println("b=" , b) return 100 , 200 } func fool3 (a string , b int ) int , r2 int ) { fmt.Println("a=" , a) fmt.Println("b=" , b) r1 = 300 r2 = 400 return r1, r2 } func main () c := fool("abc" , 111 ) fmt.Println("c=" , c) ret1, ret2 := fool3("eee" , 114514 ) fmt.Println("ret1 = " , ret1, ",ret2 = " , ret2) }
定义函数变量名在前,类型在后
有名返回值中定义的变量属于局部变量,生存域为当前大括号
包
包可以区分命令空间
go中创建一个包需要创建一个文件夹,在文件夹的go文件中使用package声明包名称,通常文件夹名和包名相同且同一文件下只有一个包
创建
1
2
3
4
5
6
7
8
9
10
package pkg1import "fmt" func Test () fmt.Println("test package" ) } func init () fmt.Println("pkg1 init" ) }
流程:创建pkg1文件夹->创建pkg1.go文件->文件中声明包
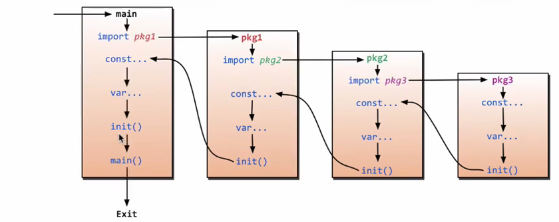
包中的init()函数为初始化函数,导包自动调用
包中的所有API都需要开头大写
导入
1
2
3
4
5
6
7
package mainimport "pkg1" func main () pkg1.Test() }
导入的包路径是从GOPATH开始的相对目录
一个文件夹下只能有一个package,一个package的文件不能在多个文件夹下,若有同名则他们彼此无关,使用时需要给每个目录定一个别名
导入的包必须使用
导包逻辑
import别名与匿名导包
使用别名 包路径给导入的包起别名
使用_ 包路径表示一个匿名导包,这样导入的包不使用也不会报错,此时无法使用当前包的方法,但是会执行init
使用. 包路径可以直接将包内方法导入导当前包,不需要用.来执行
1
2
3
4
5
import ( _ "pkg1" p2 "pkg2" . "pkg3" )
指针
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
package mainimport "fmt" func swap (a *int , b *int ) t := *a *a = *b *b = t } func main () var a int = 1 var b int = 2 fmt.Println("original a = " , a, ", b = " , b) swap(&a, &b) fmt.Println("after a = " , a, ", b = " , b) }
定义:*数据类型,二级指针**数据类型
&用于取地址,*用于解引用其实大体和C/C++一样
defer
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
package mainimport "fmt" func f1 () fmt.Println("f1" ) } func f2 () fmt.Println("f2" ) } func f3 () fmt.Println("f3" ) } func main () defer f1() defer f2() defer f3() fmt.Println("hello" ) }
结果是:
defer定义了在当前函数结束时执行的操作,类似于cpp的析构函数
当有多个defer时,执行操作顺序按照入栈顺序依次出栈执行,满足LIFO
若同时出现return和defer,执行顺序是return先于defer
数组与切片
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 package mainimport "fmt" func printArray (array [10]int ) for i :=0 ; i<len (array); i++ { fmt.Println(array[i]) } } func printSlice (array []int ) for _, value := range array { fmt.Println("value = " , value) } } func main () var array1 [10 ]int array2 := [10 ]int {1 ,2 ,3 ,4 } for i :=0 ; i<len (array1); i++ { fmt.Println(array1[i]) } for i, v := range array2 { fmt.Println("index = " , i,", value = " , v) } printArray(array2) array3 := []int {1 ,2 ,3 ,4 } printSlice(array3) }
静态数组需要定义长度,可以用{}在内部初始化值,默认值为0
静态数组传参时需要传完整的类型,且是按值传递
切片不需要定义长度,用{}在内部初始化值
切片传参时只需要传入名字 []类型,且传入的是切片内用于存储该数组地址的变量,类似于传引用
切片详解
切片的声明方式
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 slice1 := []int {1 ,2 ,3 } fmt.Println(len (slice1)) var slice2 []int slice2 = make ([]int , 3 ) fmt.Println(len (slice2)) var slice3 []int = make ([]int , 3 )fmt.Println(len (slice3)) slice4 := make ([]int , 3 ) fmt.Println(len (slice4))
声明切片,并初始化
声明一个空切片,并开辟空间
声明的同时开空间
使用:=和make自动推导
注意:判空使用slice==nil
追加与截取
1 2 3 4 5 6 7 8 9 10 11 12 var num = make ([]int , 3 , 5 )fmt.Printf("len=%d, cap=%d, slice=%v\n" , len (num), cap (num), num) num = append (num, 1 ) fmt.Printf("len=%d, cap=%d, slice=%v\n" , len (num), cap (num), num) num = append (num, 1 ) num = append (num, 2 ) fmt.Printf("len=%d, cap=%d, slice=%v\n" , len (num), cap (num), num)
切片的容量和长度是两个概念,一个切片有两个指针指向长度的头尾,切片本身的变量名就是指向底层首地址的一个指针
长度指左右指针之间的距离
容量指左指针至切片末尾的距离
其中多出的容量无法访问,但确实有这么一块空间提前开辟了
使用make构建切片时,可以指定容量:make(类型, 长度, 容量)
使用cap(切片)获取数组容量
使用append(数组, 元素)向切片追加元素,若切片容量满的情况下追加元素,切片会动态扩容到之前容量的两倍
1 2 3 4 5 6 7 8 9 s := []int {1 ,2 ,3 } s1 := s[0 :2 ] fmt.Printf("len=%d, cap=%d, slice=%v\n" , len (s1), cap (s1), s1) s2 := make ([]int , 3 ) copy (s2, s) fmt.Printf("len=%d, cap=%d, slice=%v\n" , len (s2), cap (s2), s2)
使用中括号截取切片,左闭右开,截取出的切片和原切片底层是同一个数组
使用copy函数实现深拷贝,可以将其底层数组一块拷贝
map
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 package mainimport "fmt" func main () var mymap1 map [string ]string mymap1 = make (map [string ]string , 10 ) mymap1["lang1" ] = "java" mymap1["lang2" ] = "cpp" mymap1["lang3" ] = "python" mymap1["lang4" ] = "go" fmt.Println(mymap1) mymap2 := make (map [int ]string ) mymap2[1 ] = "java" mymap2[2 ] = "cpp" fmt.Println(mymap2) mymap3 := map [string ]string { "one" : "java" , "two" : "cpp" , } fmt.Println(mymap3) }
go的map底层是哈希表,无序
四种声明方式如上,注意若不通过make声明,map是没有空间的
给一个容量已满的map添加元素,map会自动扩容到原来的两倍
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 package mainimport "fmt" func printmap (city map [string ]string ) { for key, val := range city { fmt.Printf("key=%s, val=%s\n" , key, val) } } func main () city := make (map [string ]string ) city["China" ] ="Beijing" city["US" ] = "Washington" city["Japan" ] = "Tokyo" for key, val := range city { fmt.Printf("key=%s, val=%s\n" , key, val) } delete (city, "Japan" ) city["US" ] = "DC" printmap(city) }
结构体
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 package mainimport "fmt" type myint int type Book struct { title string author string } func printBook (book1 Book) fmt.Println(book1) } func chgBook (book1 *Book) book1.author = "he" } func main () var book1 Book book1.title = "Golang" book1.author = "who" printBook(book1) chgBook(&book1) printBook(book1) }
使用type 别名 原名定义一个数据类型的别名
使用时和CPP一样
传参时是值传递,若需要修改则传指针
面向对象
定义类
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 package mainimport "fmt" type person struct { Name string Ad int Level } func (this *person) fmt.Println(this.Name) } func (this *person) string ) { this.Name = newName } func main () p := person{Name:"zhangsan" , Ad:100 , Level:1 } p.GetName() p.SetName("lisi" ) p.GetName() }
用结构体当作类,内部填属性
方法定义的时候在func后面指定是哪个类
默认对类是值传递
类名、属性名、方法名大写,说明是公用的,其他包可以访问,否则只能本包用
继承
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
package mainimport "fmt" type Human struct { name string sex string } func (this *Human) fmt.Println("eating" ) } func (this *Human) fmt.Println("walking" ) } type SuperMan struct { Human level int } func (this *SuperMan) fmt.Println("superman eat" ) } func (this *SuperMan) fmt.Println("flying" ) } func main () h :=Human{"zhangsan" , "female" } h.Eat() h.Walk() s := SuperMan{Human{"wangwu" , "male" }, 100 } s.Walk() s.Eat() s.Fly() }
继承直接在属性里写上父类
可以重写也可以定义新方法
这样创建类的时候要嵌套着写父类,或者直接var创建变量后,统一赋值
多态
GoLang的多态基于接口实现
创建一个接口:
1 2 3 4 5 6 type AnimalIF interface { Sleep() GetColor() string GetType() string }
只要添加interface标识符即可,本质上相当于一个父类指针
形成多态的基本要素:
有一个父类(接口)定义方法
有子类,需要实现父类的全部接口方法
父类类型的变量要指向子类的具体数据变量
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 package mainimport "fmt" type AnimalIF interface { Sleep() GetColor() string GetType() string } type Cat struct { color string } func (this *Cat) fmt.Println("Cat is sleep" ) } func (this *Cat) string { return this.color } func (this *Cat) string { return "Cat" } type Dog struct { color string } func (this *Dog) fmt.Println("Dog is sleep" ) } func (this *Dog) string { return this.color } func (this *Dog) string { return "Dog" } func showAnimal (animal AnimalIF) animal.Sleep() fmt.Println("color = " , animal.GetColor()) fmt.Println("type = " , animal.GetType()) } func main () var animal AnimalIF animal = &Cat{"Green" } animal.Sleep() animal = &Dog{"Yellow" } animal.Sleep() cat := Cat{"Green" } dog := Dog{"Yellow" } showAnimal(&cat) showAnimal(&dog) }
空接口
类型:interface{}
GoLang中的基本类型基本都实现了interface{},所以我们可以用这种类型引用任意的数据类型(类似于java中的Object)
并且,空接口自带类型断言机制,语法类似:变量名.(数据类型),返回两个值value和ok,前者为变量的值,后者为是否是这个数据类型
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 package mainimport "fmt" func myFunc (arg interface {}) fmt.Println("called" ) fmt.Println(arg) value, ok := arg.(string ) if !ok { fmt.Println("arg is not string" ) } else { fmt.Println("arg is string, value=" ,value) fmt.Printf("value type is %T\n" , value) } } type Book struct { auth string } func main () book:=Book{"GoLang" } myFunc(book) myFunc(100 ) myFunc("abc" ) myFunc(3.14 ) }
反射
GoLang中的语言底层由一个pair实现,见上面
1 2 3 4 5 6 func main () var s string a = "abc" var allType interface {} allType = a }
此时allType本身pair永远不变,type和value分别变成两个指针
若appType赋值,相当于把这两个指针指向对应的type和value
机制
GoLang中的reflect包提供了反射机制,可以根据形参获得对应的type和value
主要包含两个重要函数:
ValueOf:获取输入参数接口中数据的值,若接口为空返回0TypeOf:动态获取输入参数接口中值的类型,若接口为空返回nil
其他更多方法可以查阅文档
用法1
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 package mainimport "fmt" import "reflect" func reflectNum (arg interface {}) fmt.Println("type: " , reflect.TypeOf(arg)) fmt.Println("value: " , reflect.ValueOf(arg)) } type User struct { Id int Name string Age int } func reflectStru (input interface {}) inputType := reflect.TypeOf(input) inputValue := reflect.ValueOf(input) for i:=0 ; i<inputType.NumField(); i++ { field:= inputType.Field(i) value:= inputValue.Field(i).Interface() fmt.Printf("%s: %v = %v\n" , field.Name, field.Type, value) } for i:=0 ; i<inputType.NumMethod(); i++ { m := inputType.Method(i) fmt.Printf("%s: %v\n" , m.Name, m.Type) } } func (this User) fmt.Println("user is called" ) fmt.Printf("%v\n" , this) } func main () var num float64 = 1.2345 reflectNum(num) user :=User{1 ,"lihua" ,18 } reflectStru(user) }
结构体标签
我们可以给结构体打标签,标签是键值对的形式
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
package mainimport "reflect" type resume struct { Name string `info:"name" doc:"我的名字"` Sex string `info:"sex"` } func findTag (str interface {}) t := reflect.TypeOf(str).Elem() for i:=0 ; i<t.NumField(); i++ { tagstring := t.Field(i).Tag.Get("info" ) tagdoc := t.Field(i).Tag.Get("doc" ) fmt.Println("info: " , tagstring) fmt.Println("info: " , tagstring) } } func main () var re resume findTag(&re) }
使用结构体标签可以编码/解码JSON
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 package mainimport ( "fmt" "encoding/json" ) type Movie struct { Title string `json:"title"` Year int `json:"year"` Price int `json:"rmb"` Actors []string `json:"actors"` } func main () movie := Movie{"test" , 2000 , 10 , []string {"zhangsan" ,"lisi" }} jsonStr, err := json.Marshal(movie) if err!=nil { fmt.Println("JSON marshal error " , err) return } fmt.Printf("jsonStr: %s\n" , jsonStr) myMovie := Movie{} err = json.Unmarshal(jsonStr, &myMovie) if err!=nil { fmt.Println("json unmarshal error " , err) return } fmt.Printf("%v\n" , myMovie) }
JSON相关需要导入库"encoding/json"
编码使用json.Marshal,解码使用json.Unmarshal
自动生成的JSON键根据你的结构体标签json:"xxx"来定
GoRoutine
协程
多进程或多线程解决了单线程的阻塞问题,达到了宏观的并发
但是多线程的切换是有切换成本的,这部分是cpu浪费时间成本
总的来说,传统多线程有着高消耗cpu和高内存占用的缺点
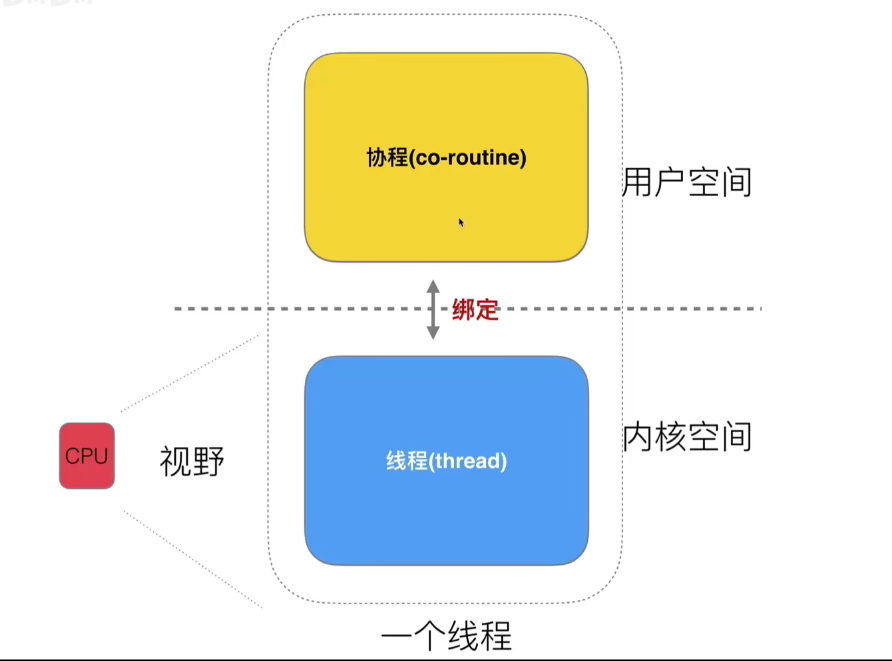
为了解决以上问题,新的多线程机制将一个线程分割为线程(内核部分)与协程(用户部分),且一一绑定
这种关系下,一个线程对应一个协程,并发时还需要切换线程,有高切换成本
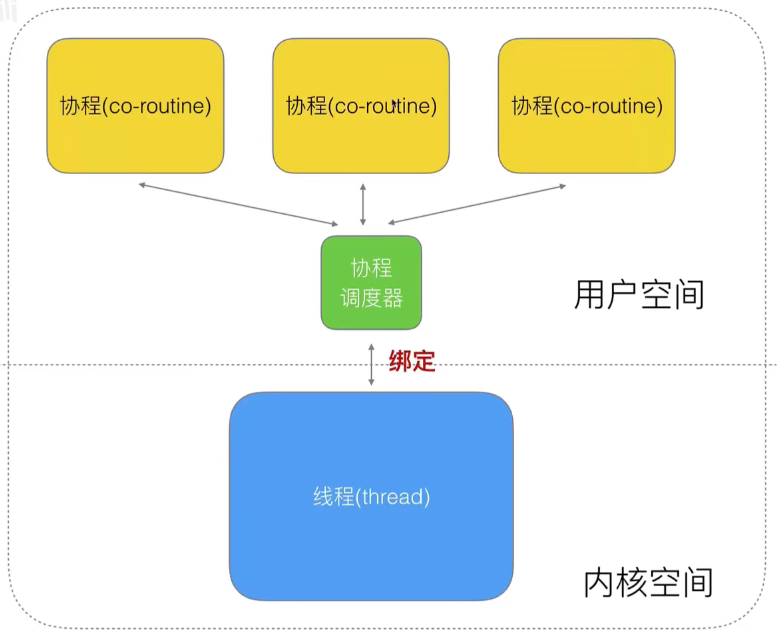
改进一下,可以通过一个协程调度器用一个线程绑定多个协程,即为n对1的协程关系,这种可以有效解决高消耗cpu的问题
但这种模型会导致其中一个协程阻塞会影响后面协程的进行
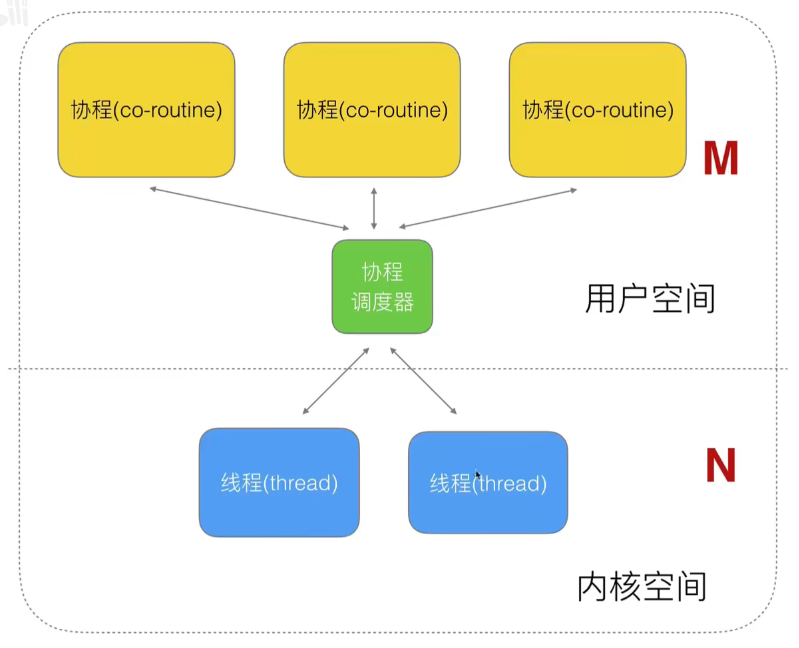
最后,我们可以让线程与协程产生n比m的关系,通过协程调度器合理分配,因此协程调度器更好,对并发优化的更好,占用就越少
GoLang对协程的处理
GoLang首先对协程优化,将co-routine改为Goroutine,并优化内存到几kb,因此可以大量生产,且Goroutine可以灵活调度,可以灵活切换
早期调度器
早期的调度器会让想要获取协程的线程获取锁和全局Go协程队列,按照队列的进出获取Goroutine并尝试执行,结束后放回队尾,并尝试还锁
缺点:
GMP模型
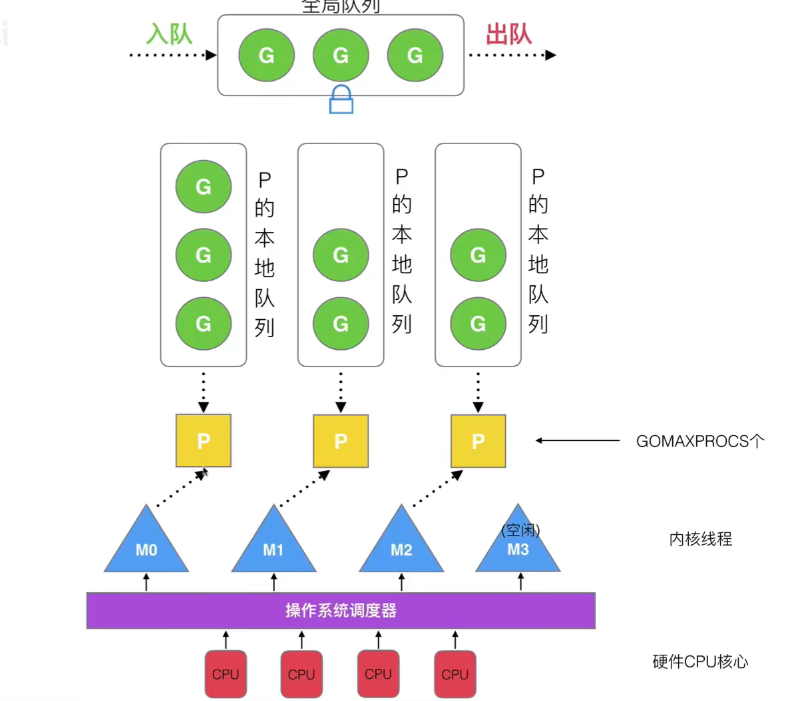
GMP即Goroutine,Machine thread和processor
Gorouting优先放入某本地队列,满了后放入全局队列
一个P同一时间只能执行一个Go,最大并行数量为GOMAXPROCS个
调度器的设计策略
复用线程
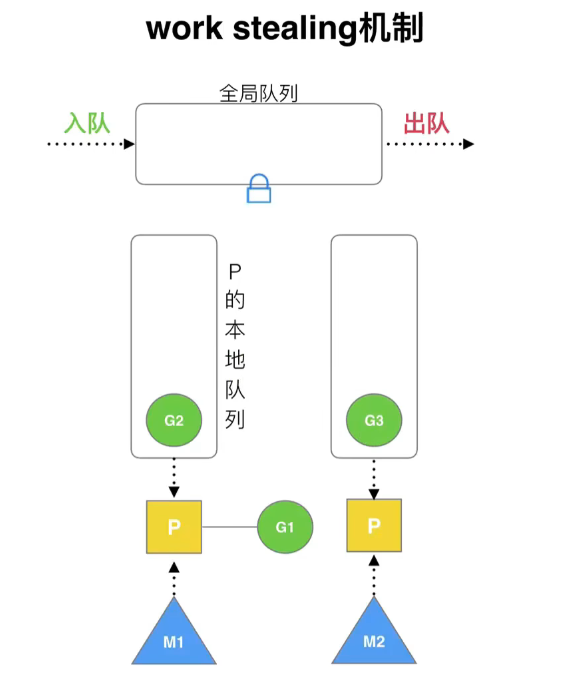
work stealing机制:
当前G1正在被M1的P执行,本地队列中有两个正在等待
此时M2会从M1偷一个G来执行,此为work stealing
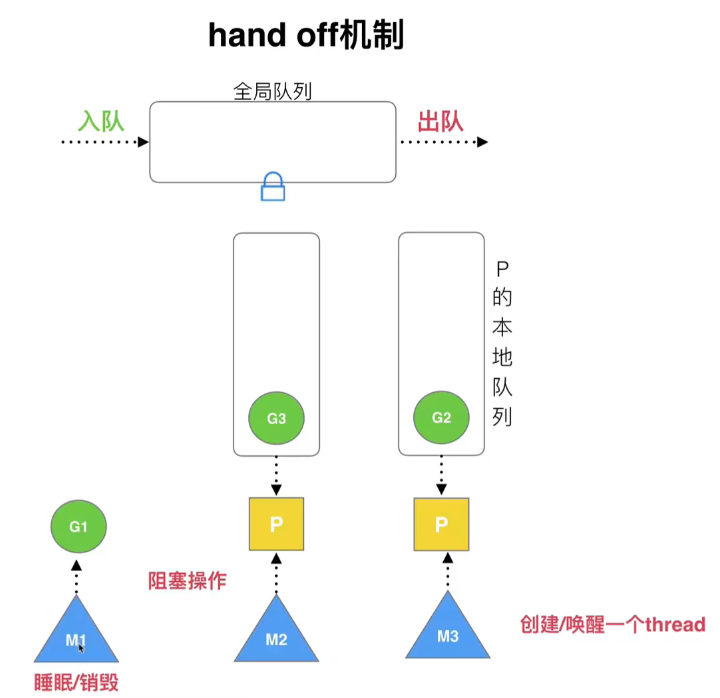
hand off机制:
当前G1正在被M1的P执行,G2在M1的队列等待,G3在M2的队列等待,即将操作
若此时G1阻塞,我们会创建/唤醒一个线程M3,将M1的P和队列移到M3,CPU切换到M2/M3执行
若G1持续阻塞,则M1处于睡眠,若G1不再执行,M1就会被销毁
利用并行
我们可以限定P的个数GOMAXPROCS=CPU核数/2
抢占
以往的co-routine和对应的cpu绑定后,若有其他co-routine想要使用该cpu,就只能等待上一个主动释放
现在的go-routine和对应cpu绑定只允许绑定一段时间(10ms),时间到后其他go-routing可以抢占该cpu
全局G队列
依照work
stealing机制,若其他本地队列中没有G,而全局G队列中有,它也会从全局G队列中获取,这个过程需要加锁与解锁
Goroutine创建
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 package mainimport ( "fmt" "time" ) func newTask () i:=0 for { i++ fmt.Printf("new Goroutine : i = %d\n" , i) } } func main () go newTask() i:=0 for { i++ fmt.Printf("main goroutine: i = %d\n" , i) time.Sleep(1 *time.Second) } }
使用go关键字后面接匿名/有名函数就可以创建goroutine
其中main是主goroutine,其他的是从goroutine,从随着主的消亡而消亡
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 package mainimport ( "fmt" "runtime" "time" ) func main () go func () defer fmt.Println("A.defer" ) func () defer fmt.Println("B.defer" ) runtime.Goexit() fmt.Println("B" ) }() fmt.Println("A" ) }() for { time.Sleep(1 *time.Second) } }
创建的匿名方法前加go就可以直接创建goroutine
使用runtime.Goexit()退出当前goroutine
注意:作为协程的方法的返回值(若有)无法被变量接收,因为执行是并发的,返回值会被丢弃。协程之间的通信需要用到channel
channel
定义
用于goroutine之间的信息交换
语法:
1 2 make (chan Type)make (chan Type, capacity)
指定channel传输类型与缓冲量
用法
向channel中写数据:channel<-value
接受并将其丢弃:<-channel
从channel中接收数据并赋值:x:=<-channel
同时检查管道是否关闭或为空:x, ok := <-channel
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 package mainimport "fmt" func main () c := make (chan int ) go func () defer fmt.Println("goroutine结束" ) fmt.Println("goroutine正在进行" ) c <- 666 }() num := <-c fmt.Println("num =" ,num) fmt.Println("main goroutine结束" ) }
运行结果:
1 2 3 4 goroutine正在进行 goroutine结束 num = 666 main goroutine结束
阻塞逻辑
channel具有同步两个不同goroutine的能力,保证了一个阻塞队列
若main goroutine提前到达获取channel数据的语句,会进入阻塞,直到sub
goroutine传入数据并唤醒阻塞
若sub goroutine提前到达发送channel数据的语句,也会进入阻塞,直到main
goroutine开始读取数据并唤醒阻塞,发送数据
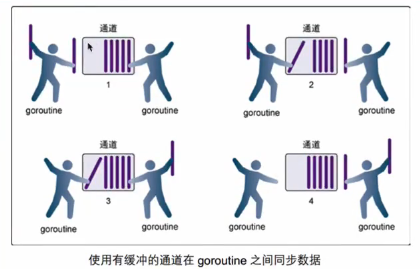
channel缓冲
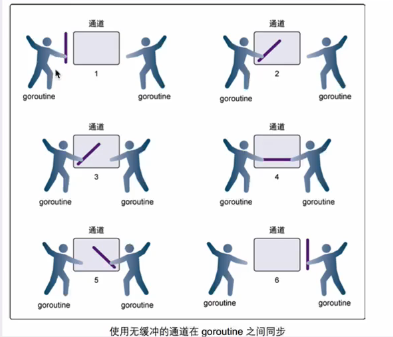
若使用无缓冲的channel,两个goroutine先进入通道的需要阻塞等待另一方,直到数据交换完成都解锁
若使用有缓存的channel,channel允许让我们在管道内存数据
左右侧的goroutine可以一直往channel内放入值和取出值,这两个操作既不同步,也不互相阻塞,直到通道满了或为空,可能会让对应的一方阻塞
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 package mainimport ( "fmt" "time" ) func main () c := make (chan int ,3 ) fmt.Println("len=" , len (c), ",cap=" , cap (c)) go func () defer fmt.Println("子goroutine结束" ) for i:=0 ; i<4 ; i++ { c <-i fmt.Println("发送元素=" ,i,"len=" , len (c), ",cap=" , cap (c)) } }() time.Sleep(2 *time.Second) for i:=0 ; i<4 ; i++ { num := <-c fmt.Println("num=" ,num) } }
输出:
1 2 3 4 5 6 7 8 len= 0 ,cap= 3 发送元素= 0 len= 1 ,cap= 3 发送元素= 1 len= 2 ,cap= 3 发送元素= 2 len= 3 ,cap= 3 num= 0 num= 1 num= 2 num= 3
删除
使用close()方法可以关闭channel
读取channel值时,可以多返回一个布尔值,表示channel是否关闭
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 package main import "fmt" func main () c := make (chan int ) go func () for i:=0 ; i<5 ; i++ { c<-i } close (c) }() for { if data, ok := <-c; ok { fmt.Println(data) } else { break } } fmt.Println("main finished" ) }
当确实没有任何发送数据时,或你想显式的结束range循环时,才去关闭channel
对一个关闭的channel发送数据会爆panic
关闭channel后,可以继续接收数据
对于一个nil channel,无论收发都会阻塞
与range
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 package main import "fmt" func main () c := make (chan int ) go func () for i:=0 ; i<5 ; i++ { c<-i } close (c) }() for data:= range c{ fmt.Println(data) } fmt.Println("main finished" ) }
可以使用range不断迭代操作channel
与select
select可以完成监控多个channel的状态
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 package main import "fmt" func fib (c, quit chan int ) x, y:=1 ,1 for { select { case c <- x: x, y= y, x+y case <- quit: fmt.Println("quit" ) return } } } func main () c := make (chan int ) quit := make (chan int ) go func () for i:=0 ; i<10 ; i++ { fmt.Println(<-c) } quit <-0 }() fib(c, quit) }
格式如下:
1 2 3 4 5 6 7 8 select { case <- chan1: case chan2 <- 1 : default : }
GoModules
Go Modules是go语言的依赖解决方案,它淘汰了原有的GOPATH的使用模式
基础环境
必须的环境变量:
GO111MODULE:Go Modules的开关,允许设置如下参数
auto:只要项目包含go.mod文件的话就启用Gomodules
on:启用Gomodules
off:禁用Gomodules
GOPROXY:设置Go模块代理,用于在后续拉取模块版本时直接通过镜像站快速拉取
GOSUMDB:值是一个Go checksum
database,用于拉取模块版本时保证拉取到的模块版本数据未经过篡改
GONOPROXY/GONOSUMDB/GOPRIVATE:用在内部仓库中,设置GOPRIVATE后,导包不会走PROXY,也不会通过SUMDB校验
通过Modules初始化项目
首先创建一个项目文件夹,cd进入
输入go mod init 模块名,模块名决定导包怎么写
初始化后出现go.mod文件,存储go版本号与模块名
写main文件,若源代码依赖了某个库,我们可以在终端中手动使用go get 模块名就可以拉下来,或者在go run的时候自动拉下来
拉下来的库在go.mod中会写入require,包含以来的模块名,版本,若有//indirect表示间接依赖
在go.sum中罗列出当前项目直接或间接依赖的所有模块版本,包括模块名、版本和哈希校验码(表示整体项目文件的全部文件的校验和哈希)
若校验码不存在,表示依赖的库可能用不上
改变模块依赖关系
如果想回退当前项目用到的包的版本,可以使用go mod edit -replace=之前依赖的版本=要替换的版本
回退后可以在go.mod看到对应的replace字段