NoSQL
非关系型数据库,适合:
- 超大规模数据
- 高并发
的场景
它把关系型数据库的磁盘IO操作转换为内存操作,因此速度会大量提升
NoSQL分为四类:
- KV(Redis):查找速度很快
- 列存储(HBase):容易进行分布式扩展
- 文档型(MongoDb):操作非常灵活
- 图形(Neo4J):社交网络常用,以图结构为数据模型
Redis简介
它是以KV对存储的NoSQL,不需要遵守传统数据库的基本要求
优点:对数据高并发读写,对海量数据高效率存储访问,单线程操作,每个操作都是原子操作,没有并发问题
为什么不是多线程:
Redis大部分操作在内存中完成,且采用了高效数据结构
这样可以避免多线程之间的竞争,省去了多线程切换带来的时间和性能开销,而且也不会导致死锁
定位
Redis实现了将磁盘IO操作转换为内存操作,即作为缓存使用,最终把数据再存入数据库
有利于提高数据读写速度,减轻对数据库的存储和访问压力
当数据量和并发非常大的时候,我们一般会先操作内存,后续再存入库,称为最终一致性
注意:Redis不建议存储敏感数据
数据类型
Redis的命令格式类似于:类型命令 key value
操作类似map的kv存储,key大部分为string类型,value根据缓存数据结构可以使用下面讲到的多种类型
String
字符串类型是包含多种类型的特殊类型,并且是二进制安全的
常用命令
set key value:将kv对缓存在redis中,设置相同key会被覆盖
get key:获得key对应的值
incr/decr key:将key对应value值±1,只能针对数值类型
setex key seconds value:将kv对缓存到redis中,seconds秒后失效
ttl key:查看key的存活时间,当数值变为-2表示已经失效
del key:删除key
setnx key value:若key已存在,不操作;若key不存在,直接添加
应用场景
计数器:如视频播放量计数使用
incr计算播放量,若直接在数据库增加对数据库的压力很大共享
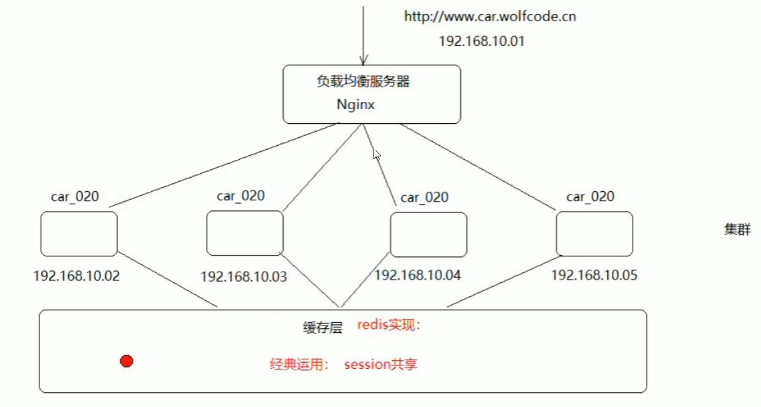
session:出于负载均衡的考虑,分布式的服务会把用户的信息访问均衡到不同服务器上,这样用户每次刷新进入的服务器不同,session中可能没有之前的登录信息,需要重新登陆
为避免这个问题,可以用redis将用户session集中管理,只需要保证redis的高可用和扩展性的,每次获取用户更新或查询登录信息都从redis集中获取
Hash
可以看作String类型的field和value的映射表,或者说是一个String集合,适合存储对象,类似于map<string, map<string, type>>
常用命令
hset key field value:将field value对缓存到对应key下
hget key field:就从key对应的hash表中获取对应field的value值
hexists key field:判断key对应hash表中有无field字段
hdel key field:删除key对应hash表中的field字段
hincrby key field increment:给key对应hash表中的field字段加1
hlen key:查看key对应hash表中的field个数
hkeys key:获取key对应的hash表中的所有fields
hvals key:获取key对应的hash表中的所有values
hgetall key:获取key对应的hash表中的所有kv对
应用场景
- 共享session:
接上面,若想要将用户信息通过redis存入缓存层,有两种方案:
- 将User对象转换为json字符串存入redis,侧重于查看,修改麻烦
- 将User对象转换为hash对象存入redis,侧重于修改,查看麻烦
List
是一个双端链表结构的集合,可以作为栈或队列使用,类似于map<string, list>
常用命令
rpush key value:从右边往key集合中添加value值
lpush key value:从左边往key集合中添加value值
lrange key start stop:从左边开始列表key的集合,从start开始,stop结束
rpop key:弹出key集合中最右边的数据
lpop key:弹出key集合中最左边的数据
llen key:获取列表长度
应用场景
- 用户收藏列表:
key:user→ value:aid1、aid2、…
Set
是String类型的无序集合,底层使用哈希表实现,类似于map<string, set<int>>
还可以对集合进行交集、并集和差集的集合运算操作
常用命令
sadd key members[...]:在key集合中添加member元素
smembers key:遍历key集合中所有元素
srem key members [...]:删除key中的members元素
spop key count:随机从key集合中弹出n个元素
sdiff key1 key2:返回两个集合的差集
sinter key1 key2:返回两个集合的交集
sunion key 1, key2:返回两个集合的并集
应用场景
- 去重
- 抽奖
Sorted set(zset)
有序的set类型
常用命令
zadd key score member:往key集合中添加member元素,分数为score
zincrby key increment member:将key集合中的member元素+increment分
zrange/zrevrange key start stop [withscores]:将key集合中的元素按分数升序/降序排列,若携带withscore参数则会显示分数
zrank/zrevrank key member:返回member元素在key集合中的正序/倒序排名
zcard key:返回key集合元素个数
zrem key member:删除key集合中member元素和分数
zrangebyscore/revrangebyscore key min max [withscore]:按照
zremrangebyscore key min max withscores:照
zremrangebyrank key start stop:删除key集合正序排名落在
应用场景
排行榜
value设计
考虑:
- 是否需要排序:使用sorted set
- 缓存数据是多个值还是单个值
- 多个值:重复-list,不重复-set
- 单个值:简单值-string,对象值-hash
也可以:
需要排序的使用sorted set,剩下的将value转换为json字符串,使用string存储,这样可以减少泛型操作的麻烦
key设计
唯一性
redis的key必须保证唯一,缓存同一个key时,后者会覆盖前者
最常用的命名方式:使用缓存数据的主键作为key,因为主键是保证UNIQUE的
如员工表的主键是id,使用id作为key
可读性
redis的key需要保证见名知意,id虽然保证唯一,但可读性非常差,因此在保证key唯一的前提下,可以给key加上前缀,规范如下:
- 普通单值,如
employee_info:id1 - 类似关系型数据库设计:表名:主键名:主键值:列名,如
employee:id:1:info - 通用命名:业务模块名:业务逻辑含义:其他:value类型,如
employee:base.info:id1:hash- 模块名:表示该key属于哪个功能模块
- 逻辑含义段:可以使用.分开,具体业务逻辑表示
- 其他:设置唯一标识,如主键
灵活性
key保证唯一的时候,可以用主键,有的用一个主键不能表达全部意思,可以使用联合主键
时效性
redis key一定要设置过期时间,要根据自己的业务场景给key设置合理的过期时间,一般在写入key时,就要追加过期时间,也可以按需动态设置
- 若不设置过期时间,这种key就是永久key,会一直占用内存不释放,时间久数量多后容易达到服务器的内存上限,导致宕机;一般配合key过期策略使用
- key的时效性设置,必须根据业务场景评估,设置合理有效期
全局命令
全局命令针对的是所有key,用于运维管理
keys pattern:按照pattern匹配规则列出所有keys
exist key:判断key是否存在
expire key seconds :给key设置过期时间
persist key:取消key过期时间
select index:切换数据库,共有0-15共16个,默认第0个
move key db:移动key到其他数据库
randomkey:随机命名key
rename key newkey:重命名key
Redis事务
一个事务从开始到执行会经历:开始事务、命令入队、执行事务的三个阶段
单个Redis命令的执行是原子性的,但Redis没有在事务上增加任何维持原子性的机制,所以Redis事务的执行不是原子性的
Redis的事务可以理解为一个打包的批量执行脚本,但不是原子化操作;中间某个指令执行失败不会导致前面已做指令的回滚,也不会导致后续的指令不做
使用multi开启一个事务,这之后添加的命令都会标记为queued,当执行exec命令后才会统一执行,注意:
- 事务中任意命令执行失败,其余命令依然被执行
- 在事务执行过程中,其他客户端提交的命令请求不会插入到事务执行命令队列中
Redis持久化
Redis的持久化机制类似如下:
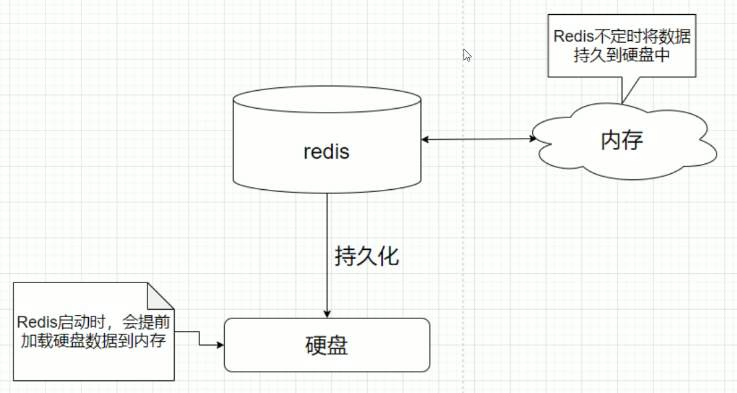
分为三种:
- 快照方式(RDB)
- 文件追加方式(AOF)
- 混合持久化
RDB方式
默认方式,将内存数据以快照的方式写入到二进制文件中,默认为dump.rdb触发RDB持久化过程分为手动和自动触发
- 手动触发
- save命令:会阻塞当前Redis服务器,直到RDB过程完成为止,如果内存数据较多,会造成长时间阻塞,影响其他命令使用,不建议使用
- bgsave命令:Redis进程执行fork指令创建子进程,由于进程实现RDB持久化,建议使用该命令
- 自动触发:使用
save m n表示m秒内数据集存在n次修改时会自动触发bgsave命令
优点:
- RDB快照文件是一个压缩的二进制文件,适用于备份、全量复制登场景,开发中可以按照每六小时执行一次备份用于容灾备份
- Redis加载RDB回复数据远远快于AOF方式
缺点:
- 无法做刀持久化/秒级持久化,执行fork有时间成本
- 快照文件不同版本格式不同,有兼容问题
AOF方式
AOF以独立日志方式记录每次写命令,重启时再重新执行AOF文件中命令达到恢复数据的目的,解决了数据持久化实时性的问题
默认是不开启AOF的,需要配置appendonly yes的情况下才会开启
AOF有三种文件同步策略:
appendfsync always:收到命令就立即写到磁盘,效率最慢,但是持久化最完全appendfsync everysec:每秒写入磁盘一次,折中appendfsync no:完全依赖os,一般周期是30s
优点:
- 数据安全性更高,最多损失一秒数据量
- 不小心执行了flushall指令,也可以通过AOF方式删除最后一个命令来恢复
- AOF是一个增量日志文件,不会存在断电时出现损坏问题,即使有问题也可以通过
redis-check-aof恢复 - AOF变得太大时,Redis能够在后台重写AOF
缺点:
- AOF文件体积通常大于RDB文件
- 持久化性能来说,AOF慢
混合持久化
在写入时,先把当前的数据以RDB形式写入开头,再将后续的操作命令以AOF格式存入文件,即以RDB为全量备份,AOF作为增量备份来提高备份效率,这样既能保证速度,又能防止数据丢失
机制选择
- 若对数据安全性有非常高的要求:同时启用
- 若能容忍数据丢失:单独使用RDB
- 不建议单独使用AOF
- 无特殊要求,可以使用混合方式
缓存机制
内存淘汰机制
Redis启动时会加载一个配置maxmemory,表示默认设置Redis内存上限,当内存达到上限后,会执行Redis内存淘汰机制
常见的淘汰策略:
LRU:最近最少使用
使用双向链表+哈希表的方式存储,双向链表存储kv对,哈希表存储key与链表节点的指针关系,当某个key被访问到时,程序可以通过哈希表迅速定位到链表节点,并将该节点调整至链表的最开始位置
LFU:最不经常使用
元素数据会附加一个属性:使用次数,通过链表串起来,被访问次数最多的放在最前面,最少的放在最后面
TTL:最靠近过期时间的
随机淘汰
Redis淘汰策略
Redis通过maxmemory-policy来配置指定具体淘汰机制
volatile-lru:对设置过期时间的数据集,执行lru淘汰策略volatile-lfu:对设置过期时间的数据集,执行lfu淘汰策略volatile-ttl:对设置过期时间的数据集,执行ttl淘汰策略volatile-random:对设置过期时间的数据集,随机淘汰allkeys-lru:对所有数据集,执行lru淘汰策略allkeys-lfu:对所有数据集,执行lfu淘汰策略allkeys-random:对所有数据集,随机淘汰no-enviction:报错,告诉你内存不足
默认是报错
过期key处理
key过期的清理问题:
- 惰性删除:当访问key时,才判断是否过期,若过期就直接删掉,对CPU友好,但会浪费内存
- 定时删除:设置key过期时间的同时创建定时器,当到达过期节点时立即执行删除key操作,对CPU不友好,需要额外让出CPU维护定时器
- 定期删除:隔一段时间对数据进行一次检查,删除里面的过期key,删多少由算法决定
Redis实际配合使用惰性删除和定期删除两种策略,当不主动删除时都是采用惰性删除
缓存一致
更新数据库和更新/删除缓存是两个独立操作,无法做到原子性,因此要尽量做到:
- 缩短不一致时间
- 保证最终一致性
- 避免长时间的脏数据
Cache Aside
核心思想:应用自己控制缓存和数据库的读写,当缓存的数据有更新值了,采用删除缓存数据而不是更新缓存数据
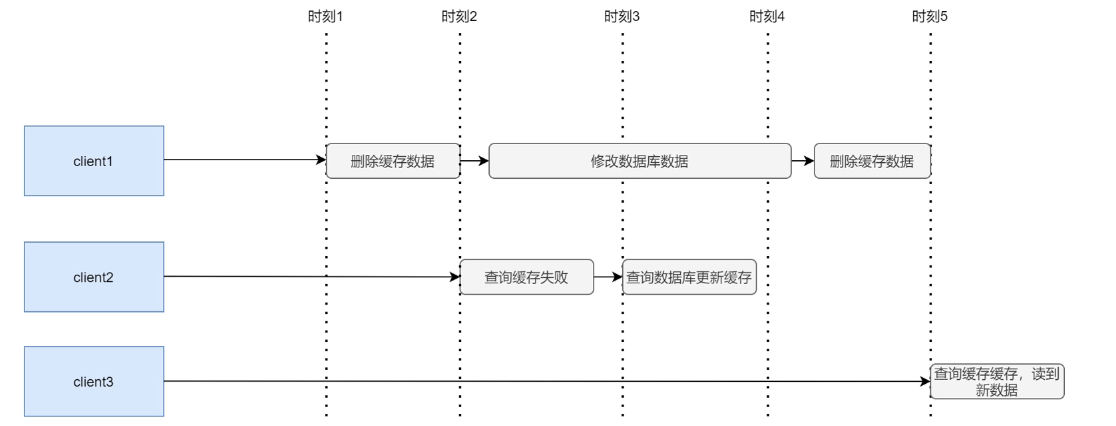
模式1:先删后改
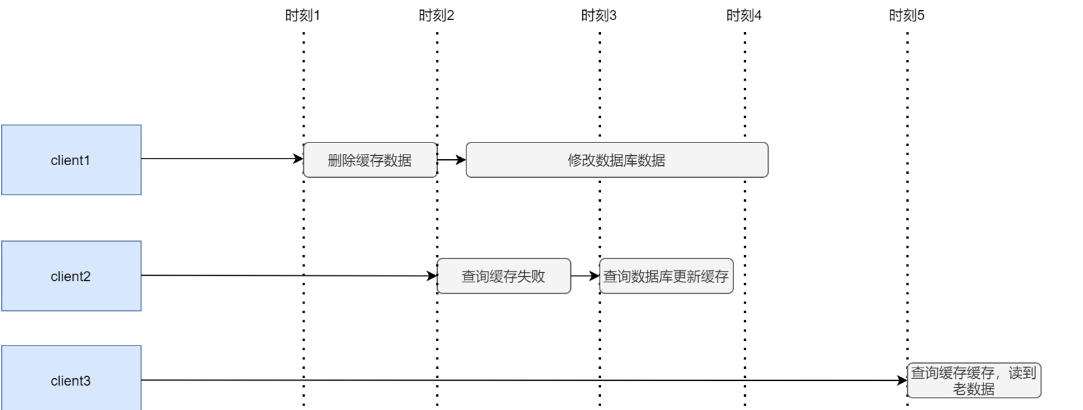
此时写请求慢于读请求,修改数据库的操作一般晚于查询数据库更新缓存的操作,导致后面用户读缓存失败,读数据库读到旧值,并回填旧值缓存,最后导致数据库是新值而缓存是旧值
可以使用延时双删策略:完成修改后,重新删除更新的一次老缓存数据,再查询时会把新的数据回填,这样即使有读请求抢先回填了旧值,第二次删除也会把旧值删掉
缺点是延迟时间难以精确控制,太短删不掉,太长影响性能
模式2:先改后删
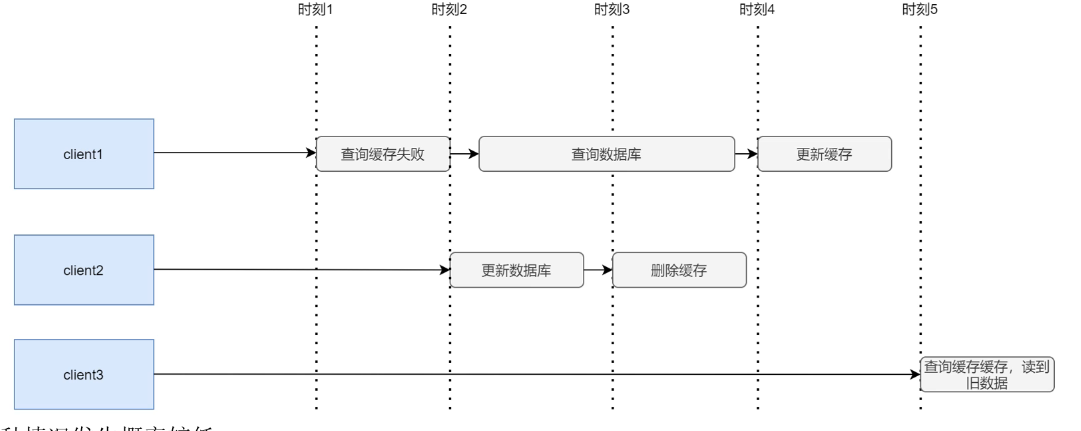
问题:假设数据库更新成功但删除缓存失败,会导致缓存是旧值而数据库是新值
解决方法:
- 重试删除:若删除失败,放入重试队列异步重试删除
- 订阅binlog删除缓存:使用工具监听MySQLbinlog,若数据变更,自动删除对应缓存
- 设置缓存过期时间TTL:即使删除失败,缓存最后也会过期,可作为兜底
一般第二种模式更常用,因为先改数据库后,缓存删除前的不一致窗口更小,且删除操作幂等
Read/Write Through
应用不直接操作数据库,把缓存作为主要的数据读取方式
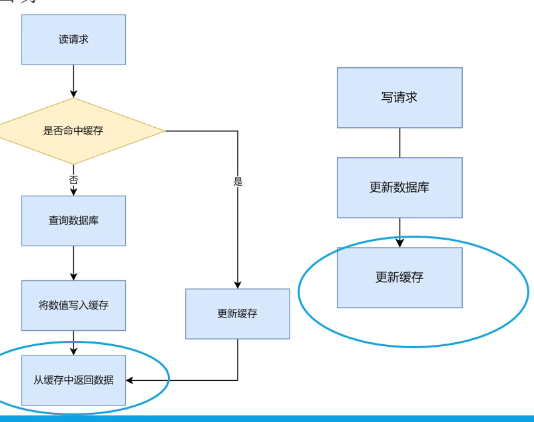
特点点:
- 对应用透明,应用代码简单
- 一致性强,但写延迟高
- 实现复杂,缓存层需要处理并发和双写等逻辑
Write Behind
核心思想:写请求先更新缓存,立即返回成功;数据库由后台异步批量更新
实现逻辑类似于:首先更新缓存,并标记该key为脏数据,立即返回成功,后台异步线程定期定量批量将脏数据刷到数据库,一般需要如下组件:
- 缓存存储:Redis等保存最新数据
- 脏数据队列/Map:记录哪些key已经修改但未持久化到数据库
- 后台Flush线程:定时触发或达到阈值时触发批量写入
- 版本号/时间戳:防止刷盘期间又有新写入导致旧值覆盖新值
- 失败重试机制:刷盘失败后重新入队,保证最终一致
- 持久化WAL:先将操作写入日志,若崩溃恢复后重放
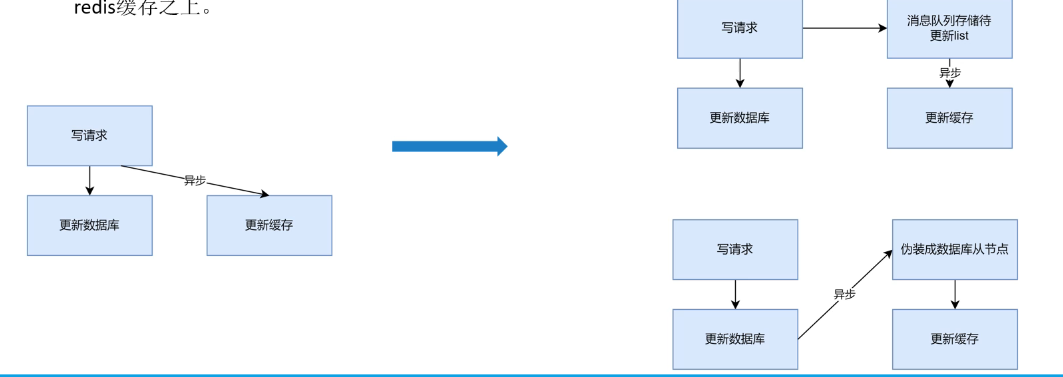
方式1:将更新步骤放到消息队列中,异步执行
从缓存到数据库:用户更新缓存后,发送mq消息,消费者异步写数据库
方式2:模拟MySQL主从复制,让MySQL认为是从节点,从而把更新的binlog发出并解析,转为结构化数据给下游程序使用
这是数据库变更捕获(CDC)的方法,数据库先更新,通过binlog等异步通知缓存或其它系统进行更新,常用于解决删除缓存失败,多实例缓存同步等问题,通常用于删除缓存
优点:
- 写延迟低:不需要等待数据库
- 吞吐高:后台批量写数据库,减少连接数和IO
- 合并写:同一key的多次更新可以合并写一次操作,减轻数据库压力
缺点:
- 数据可能丢失:若脏数据还没刷到数据库发生崩溃等,会丢失,需要WAL等持久化机制弥补
- 一致性弱:只能保证最终一直性
- 实现复杂
缓存击穿
查询某个数据的值,缓存中没有,数据库中有,因此想查询只能直接打到数据库上查询
一般缓存都会设置过期时间,所以缓存击穿比较常见
带来的问题:若对某条数据的查询突然特别大,由于缓存中无该数据,所以大量请求会打到后端数据库中,导致数据库宕机
解决方法:
- MySQL:通过加锁等方式减少击穿后的直接流量
- Redis:
- 设置热点数据不过期
- 热点数据后台启动异步线程,重新把数据回填进缓存层
缓存穿透
查询一个数据,缓存查不到数据库也查不到,导致穿透
解决方法如下:
- 拦截非法查询请求
- 缓存空对象
- 布隆过滤器:设计k个各不相同的哈希映射函数,把数据库的有效时间通过这个映射函数得到数组指定位置,并设置为1;查询时,输入查询数据,通过这一系列哈希函数判断对应位置是否全为1,若是,则很大概率是有效请求,如果有一个是0,则一定是无效查询
缓存雪崩
一大批被缓存的数据同时失效,对于这批数据请求全打到数据库上,导致数据库宕机
和缓存击穿的区别是单点与全面,所以可以用缓存击穿的方式解决:
MySQL:通过加锁减少并发量
Redis:
- 设置热点数据永不过期
- 在上线前根据情况分析,将热数据直接加载到缓存系统
- 分析失效时间,尽量让失效时间分散
集群
主从复制
多台服务器安装了Redis的情况下,将一台机器设为主库,其余设置为从库,它们之间保持数据同步,若客户端有一些写命令,会打到主库上,主库修改后会将数据同步到从库;而读命令可以直接询问从库
首先需要修改配置文件,指定谁是主库谁是从库;上线后主从库会进行握手通信,当握手完成后,从库需要向主库发送PSYN命令,开启数据同步过程,并发送主库ID和复制进度偏移量offset
主库收到信息后,会进行逻辑判断,判断该怎么继续执行步骤,告诉从库是进行全量复制(第一次上线)还是断线后重复制(断线重连)
全量复制
初次复制后进行同步:
- 主库执行
bgsave,生成对应RDB文件,并开启缓存区,记录RDB文件执行过程中,收到的新数据命令 - RDB文件产生后,主库把它发给从库,从库通过RDB恢复数据
命令传播
- 当主库状态被修改(增加。修改数据),为了使得从库和主库数据状态一致,主库会把数据变更命令发给从库,从库收到后执行命令
断线后重复制
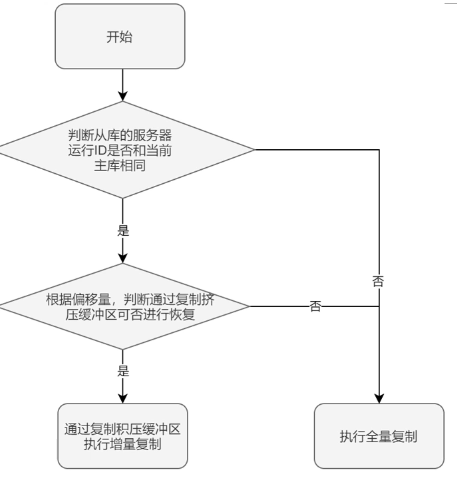
当从库和主库断线重连后,需要同步数据,依赖以下数据:
- 服务器运行ID:唯一确定主库身份
- 复制偏移量:代表主节点传输的字节数
- 复制积压缓冲区:先进先出的队列,存储最近主节点的数据修改命令
哨兵
新建哨兵组,对主从库统一监控,如果主库坏了,哨兵组进行投票,从从库中重新选出主库,本质上说,哨兵系统是一个不提供数据服务的Redis服务器
每个机器会向烧饼一定时间发送信息(心跳),哨兵系统如果一定时间收不到这个信息,就默认这个机器断联
具体逻辑是:当某个哨兵发现主库连不上,会标记为主观下线,并通知其他哨兵连接主库
超过半数哨兵确认连接不上后,就会标记为客观下线,并执行故障转移
故障转移的过程中,会通过选举协议,在所有哨兵中选择一个节点主持新主库的选举工作,选取完成后,哨兵会对这个从库发送slave of no one,该从库就会变为主库,同时向其他slave发送新主库的IP和端口号
如果此时主库重新上线,就会把他降级为从库,从属于新主库
Cluster
Cluster是Redis提供的分布式数据库解决方案,它会自动将你的数据切分为多个节点存储,即使一部分宕机,也可以继续执行数据操作
分区策略
采用虚拟槽,所有键通过CRC16校验函数,对16384取模,决定数据分配到哪个槽位,每个Redis的cluster节点负责一部分槽数据的存储,并且该节点可以结合主从复制模式,将分配给它的数据进行复制
查询策略
每个节点会存储整个集群节点信息,也称元信息,这个节点存储的元数据包括在该节点视角下:
- 各个节点存储的槽数据
- 各个节点的master和slave状态
- 各个节点是否存活
元数据信息的传播会通过gossip协议,每个节点都把自己的数据信息通过该协议散布出去
- 每隔一段时间执行一次传播
- 所有被感染的节点选择k个邻接节点散布信息
扩容缩容
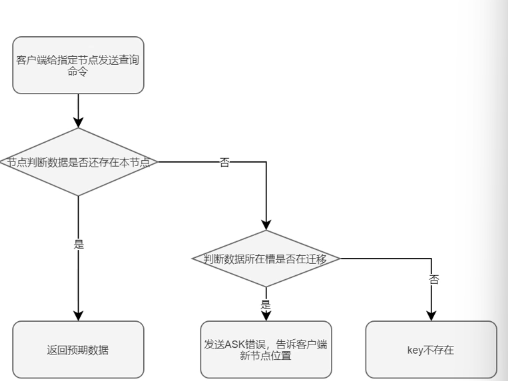
由于集群数据可能出现服务器扩容,服务器缩容,该过程中,数据会发生迁移,因此此时查询的时候可能会出现一部分数据还在本节点,一部分数据被迁移到其他节点
具体逻辑如下: